
Was sind Chunks? Wie funktionieren sie und wie arbeite ich damit?
Nordshop Insights · Enterprise Memory
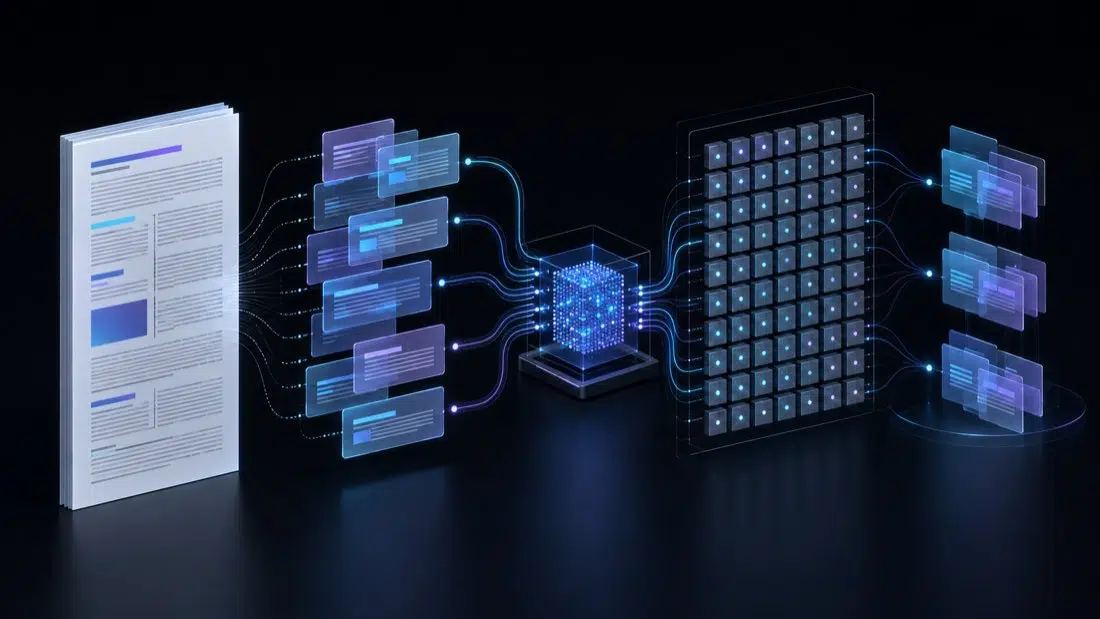
Heute möchte ich einmal zeigen, ich unsere Knowledge-Bibliothek tatsächlich aufgebaut habe. Denn zwischen “Wir haben eine Wissensdatenbank.” und “Unsere KI kann wirklich fundierte Antworten geben.” liegen eine ganze Menge Entscheidungen.
Am Anfang standen bei mir keine Chunks. Am Anfang standen Fachartikel. Jeder Artikel behandelt genau ein Thema.
Zum Beispiel:
- Was ist Zero Click?
- Warum funktioniert der klassische Sales Funnel immer schlechter?
- Welche Rolle spielen KI-Agenten im Vertrieb?
- Was unterscheidet Korrelation von Kausalität?
Jeder Artikel beantwortet genau eine Leitfrage, nicht zwei, nicht fünf- eine.
Dadurch entsteht bereits eine klare fachliche Struktur. Jeder Artikel besitzt außerdem einen eindeutigen Titel, einen eindeutigen Slug, vollständige Metadaten und Beziehungen zu thematisch passenden Artikeln.
Ich habe also zunächst das Wissen strukturiert – nicht die KI.
Erst danach stellt sich die Frage: "Wie findet eine KI später genau die Informationen, die sie für eine konkrete Frage benötigt?"
Jetzt kommen die Chunks ins Spiel.
Unsere Artikel werden nicht einfach nach jeweils 500 oder 1.000 Zeichen zerschnitten. Das wäre zwar technisch einfach, würde aber häufig wichtige Zusammenhänge zerstören.
Stattdessen zerlege ich sie in die jeweils kleinsten inhaltlich sinnvollen Einheiten eines Dokuments – sogenannte Chunks.
Jeder Chunk enthält einen abgeschlossenen Gedanken, den eine KI unabhängig vom Gesamtdokument verstehen, gezielt finden und als verlässliche Quelle für ihre Antworten nutzen kann.
Ich orientiere mich also an der fachlichen Struktur und nicht an der Zeichenanzahl.
Eine Definition bleibt mit ihrer Erklärung zusammen. Eine Argumentation wird nicht mitten im Gedankengang getrennt. Eine Fallstudie bleibt vollständig erhalten. Ein Fazit wird nicht vom eigentlichen Inhalt getrennt.
Aus jedem dieser Chunks wird anschließend ein sogenanntes Embedding (was das ist, darüber schreibe ich im nächsten Artikel) erzeugt.
Man kann sich das wie einen mathematischen Fingerabdruck der Bedeutung vorstellen. Nicht die einzelnen Wörter werden gespeichert, sondern das, worum es in diesem Wissensbaustein geht.
Alle diese Embeddings werden anschließend in einer Vektordatenbank gespeichert. Erst jetzt kann eine KI intelligent suchen.
Nehmen wir eine Frage wie : “Ist der klassische Sales Funnel im KI-Zeitalter noch sinnvoll?”
Unsere KI durchsucht jetzt nicht alle 122 Fachartikel. Sie sucht zunächst nach den Chunks, deren Bedeutung am besten zu dieser Frage passt.
Zum Beispiel findet sie Wissensbausteine aus den Artikeln über:
- den klassischen Sales Funnel,
- seine Grenzen,
- Zero-Click-Informationsverhalten,
- Touchpoint-Marketing,
- das Dynamische Resonanzmodell,
- und die abschließende Synthese.
Diese wenigen Chunks bilden anschließend den Kontext für das Sprachmodell. Die eigentliche Antwort schreibt dann die KI.
Aber sie schreibt nicht aus dem Bauch heraus. Sie schreibt auf Basis genau der Wissensbausteine, die vorher gefunden wurden.
Genau deshalb war der Aufbau unserer Knowledge-Bibliothek keine Fleißarbeit, sondern ein Architekturprojekt. Ich habe nicht einfach 122 Artikel geschrieben (mit Notebook LM), ich habe Wissen so organisiert, dass eine KI später damit arbeiten kann. Für mich war das eine der wichtigsten Erkenntnisse der vergangenen Monate.
Viele Unternehmen beschäftigen sich zuerst mit dem Sprachmodell. Ich glaube inzwischen, dass das die falsche Reihenfolge ist. Die eigentliche Qualität einer KI entsteht lange bevor die erste Frage gestellt wird.
Sie entsteht dort, wo Wissen sauber strukturiert, logisch miteinander verbunden und so aufbereitet wird, dass eine Maschine den Zusammenhang wiederfinden kann.
Das Sprachmodell liefert die Sprache. Die Qualität der Antwort entsteht aber durch die Qualität des Wissens. Und genau deshalb investieren ich heute deutlich mehr Zeit in die Architektur unseres Wissens als in die Auswahl des nächsten KI-Modells.
Eine Frage wurde mir häufiger gestellt: Zerlegt Codex eigentlich automatisch alle Texte in Chunks?
Die Antwort lautet: Nein. Codex kann Texte lesen, analysieren und bearbeiten. Soll daraus jedoch eine dauerhaft durchsuchbare Wissensdatenbank entstehen, muss das Chunking bewusst geplant und implementiert werden.
Nicht die KI entscheidet, wie Wissen strukturiert wird – diese Aufgabe liegt beim Menschen. Genau darin liegt einer der wichtigsten Erfolgsfaktoren professioneller KI-Anwendungen.
Ich habe folgenden Prompt für Codex geschrieben um zu erreichen, das alle Texte in "Wissenbausteine" (Chunks) zerlegt werden (für alle, die gerade an einer Wissensdatenbank arbeiten):
Prompt
Ziel
Erweitere unsere bestehende Knowledge-Bibliothek um eine professionelle Retrieval-Schicht (RAG). Grundlage sind ausschließlich die vorhandenen Markdown-Artikel. Die bestehende Bibliothek darf inhaltlich nicht verändert werden.
Grundprinzip
Die bestehenden Artikel bleiben die fachliche Quelle. Zusätzlich wird eine semantische Wissensebene aufgebaut. Dokumente dürfen nicht als Ganzes indexiert werden. Sie müssen zunächst in sinnvolle Chunks zerlegt werden.
Chunking-Regeln
Ein Chunk orientiert sich an der fachlichen Struktur, nicht an einer festen Zeichenzahl. Behalte vollständige Gedankengänge zusammen.
Trenne niemals:
- Überschrift und zugehörige Erklärung
- Definition und Erläuterung
- Argument und Schlussfolgerung
- Beispiel und Interpretation
- Warnhinweis und Beschreibung
- Fazit und vorherige Begründung
Falls ein Abschnitt sehr lang wird, darf innerhalb eines logisch abgeschlossenen Unterthemas weiter unterteilt werden. Ein Chunk soll immer eigenständig verständlich bleiben.
Jeder Chunk benötigt folgende Metadaten:
- eindeutige Chunk-ID
- Artikel-ID
- Artikel-Slug
- Titel
- Kapitelüberschrift
- Position im Artikel
- Wortanzahl
- Zeichenanzahl
- Status
- Kategorien
- Tags
- Related-Artikel
- Erstellungsdatum
- Änderungsdatum
Embedding
Erzeuge für jeden Chunk ein Embedding. Speichere niemals nur das Embedding. Speichere immer:
- Originaltext
- Embedding
- sämtliche Metadaten
Index
Baue einen semantischen Suchindex auf. Die Suche soll zunächst relevante Chunks finden. Erst danach werden diese Chunks an das Sprachmodell übergeben.
Retrieval
Bei einer Benutzerfrage:
- Embedding der Frage erzeugen.
- Ähnlichkeit zum Chunk-Index berechnen.
- Die relevantesten Chunks auswählen.
- Diese Chunks inklusive Quellen an das Sprachmodell übergeben.
- Antwort ausschließlich auf Basis dieser Quellen erzeugen.
Antwortqualität
Die Antwort soll nach Möglichkeit mehrere passende Artikel kombinieren. Sie soll nicht nur den ähnlichsten Chunk verwenden. Falls verschiedene Artikel unterschiedliche Positionen vertreten, sollen diese gemeinsam dargestellt werden.
Nachvollziehbarkeit
Jede Antwort muss nachvollziehbar machen,
– aus welchen Artikeln sie stammt,
- welche Chunks verwendet wurden,
- welche Leitfragen zugrunde lagen.
Performance
Der Index muss inkrementell aktualisierbar sein. Neue oder geänderte Artikel dürfen nicht den gesamten Index neu erzeugen.
Qualitätssicherung
Erstelle Tests für:
- korrektes Chunking
- keine verlorenen Inhalte
- vollständige Metadaten
- Embedding-Erzeugung
- semantische Suche
- Quellenzuordnung
- Mehrquellen-Retrieval
- inkrementelles Reindexing
Wichtig
Die bestehende Markdown-Bibliothek bleibt unverändert. Die Retrieval-Schicht wird ausschließlich ergänzend aufgebaut. Es darf keine bestehende Funktion der Knowledge-Bibliothek verändert oder verschlechtert werden.
Der Prompt ist zugegeben ziemlich lang geworden.
Aber ich habe ihn bewusst nicht gekürzt.
Zum einen, weil er genau so in einem realen Projekt zum Einsatz gekommen ist und sich dort bewährt hat. Zum anderen, weil ich zeigen möchte, dass gute Ergebnisse mit KI selten durch einen einzelnen “Zauber-Prompt” entstehen.
Entscheidend ist die klare Beschreibung des Ziels, der Architektur, der Qualitätsanforderungen und der Randbedingungen.
Vielleicht ist dieser Prompt deshalb nicht nur inhaltlich interessant, sondern auch strukturell. Er zeigt, wie ich heute mit KI arbeite: nicht durch möglichst raffinierte Formulierungen, sondern durch präzise Anforderungen, nachvollziehbare Regeln und klare Qualitätskriterien.
Denn meine Erfahrung aus den vergangenen Monaten ist:
Die Qualität der Antwort beginnt nicht beim Sprachmodell – sie beginnt bei der Qualität der Aufgabenbeschreibung.
Ich hoffe, der Artikel hat Ihnen gefallen, war informativ und hat vielleicht den einen oder anderen Denkanstoß gegeben.
Wenn er Sie dazu motiviert, sich intensiver mit dem Aufbau eigener Wissensdatenbanken und professionellen KI-Anwendungen zu beschäftigen, dann hat er seinen Zweck erfüllt.
Ich freue mich wie immer auf Ihre Gedanken, Fragen und Erfahrungen in den Kommentaren.